GUSUM
摘要:
无监督提取文档摘要的目的是在不需要标记语料库的情况下,从文档中提取突出的句子。在现有的基于图的方法中,顶点和边的权重通常是通过计算句子相似度来创建的。本文提出了一种基于图的无监督摘要(GUSUM)抽取文本摘要的方法,该方法基于在摘要中包含最重要的句子而剔除意义相近的句子的原则。我们用最新的句子嵌入模型和句子特征改进了传统的图排序算法,并改进了句子中心性的计算方法。我们首先定义顶点上表示的句子特征分数,表示文档中每个句子的重要性。在此阶段之后,我们使用Sentence-BERT来获取句子嵌入,以更好地捕捉句子的意思。通过这种方式,我们定义了表示语义相似性的图的边。接下来,我们创建一个无向图,其中包括句子的意义和句子之间的相似性。在最后一个阶段,我们用我们在创建的图表上建议的排序方法确定文档中最重要的句子。在CNN/每日邮报、纽约时报、arXiv和PubMed数据集上的实验表明,在自动和人工评估的情况下,我们的方法在无监督的基于图的摘要上取得了很高的性能
方法
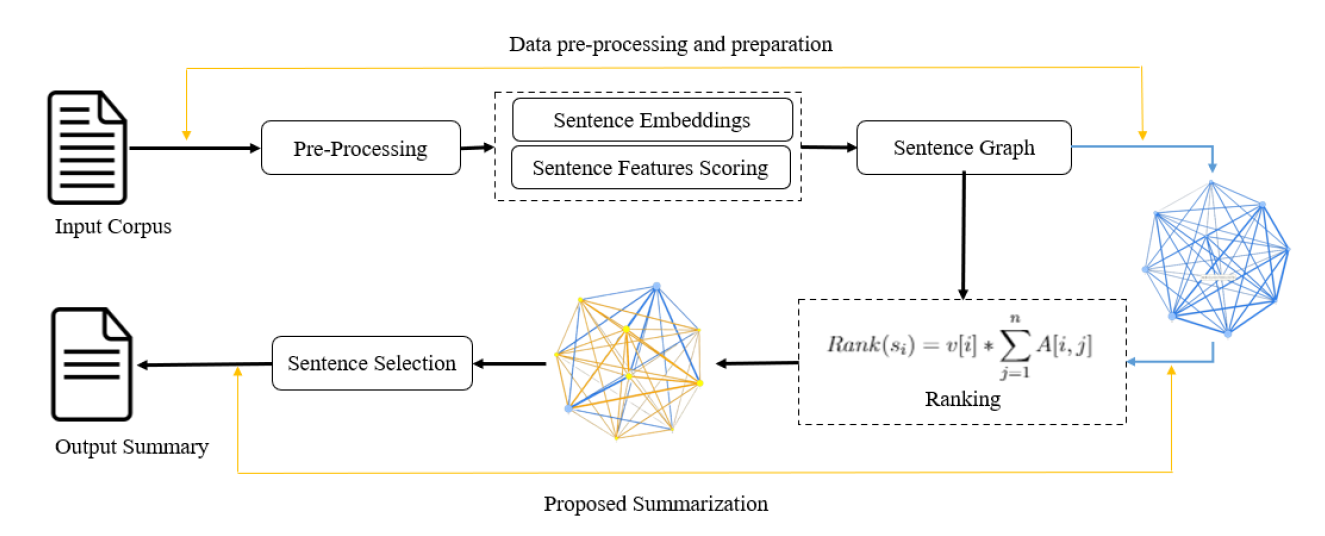
该系统主要由四个步骤组成:
首先,计算语句特征来定义顶点权重;
其次,我们通过SentenceBERT生成句子嵌入来度量句子相似度;
接下来,我们通过比较得到的所有句子嵌入对来创建一个图表;
最后,我们根据图中句子的中心性程度对句子进行排序。
计算句子特征
与传统方法不同,GUSUM使用句子特征来确定生成图中顶点的初始秩,而不是向量化它们。
GUSUM关注每句话的四个特征。在每个句子的分数确定之后,通过取代表句子的顶点的权重来分配分数的总和。
*句子长度
*句子位置
*专有名词
*数字标记
句子嵌入计算
在提取完句子之后,下一步是使用Sentence-BERT生成每个句子的句子嵌入。
Sentence-BERT是预先训练的BERT网络的修正,该网络使用连体和三元网络结构来派生语义意义的句子嵌入,可以使用向量相似方法进行比较。
该方法使用句子- bert1嵌入将句子表示为固定大小的向量。因此,所有的句子和源被映射到同一个语义空间中,并被作为系统的输入。
句子图的生成
在我们的基于无监督图的提取摘要方法中,文档表示为图,其中每个节点表示输入文档中的一个句子。
给定一个文档D,它包含一组句子(s1, s2,…sn)。基于图的算法将D视为图G = (V;E). V = (v1, v2,…, vn)是顶点集,其中vi是句子si的表示。E是边集,它是一个n × n矩阵。Each = ei,j∈E表示顶点vi和vj之间的权值。
在基于图的摘要方法中,利用中心性,通过排序选择最突出的句子来构建摘要。节点的中心性度量其在图中的重要性。
基于图的排序的关键思想是计算每个句子(或顶点)的中心性得分。
得到每句话的中心性分数后,对句子进行倒序排序,排在前面的句子被包含在摘要中。GUSUM在计算中心性时包含了句子图的顶点权重。因此,作为第一步,确定句子图的初始秩值。
构建句子图的第二步是生成表示语义句子相似点的边。余弦相似度可以作为一种衡量图中句子之间相似度的方法。在这一步中,所有两两的余弦相似点被收集到一个矩阵中。余弦相似度定义为:

设D = (s1;s2;…;Sn)是一份文件。我们使用句子特征评分,V = (v1, v2,…, vn)是顶点集,其中vi是句子si的表示。(e1;e2;…;En)是一组向量,其中ei是si的句子嵌入。根据相应句子嵌入的余弦相似度对其边进行加权。
接下来,我们用计算矩阵A:

排名与摘要评选
在本节中,我们提出了一种基于加权无向图的排序方法。基于文档中最重要的句子是根据相似度度量与所有其他句子最相似的句子的想法,我们修改了公式,将顶点权重包含进来。因此,我们将每句话的重要性等级定义如下:


其中抽取排名前k的句子作为摘要。