MERIT
论文信息
论文标题:Multi-Scale Contrastive Siamese Networks for Self-Supervised Graph Representation Learning
论文作者:Ming Jin,Yizhen Zheng,Yuan-Fang Li,Chen Gong,Chuan Zhou,Shirui Pan
论文来源: 2021,IJCAI
一、Abstract
问题:现有的图表示学习技术严重依赖标记信息。
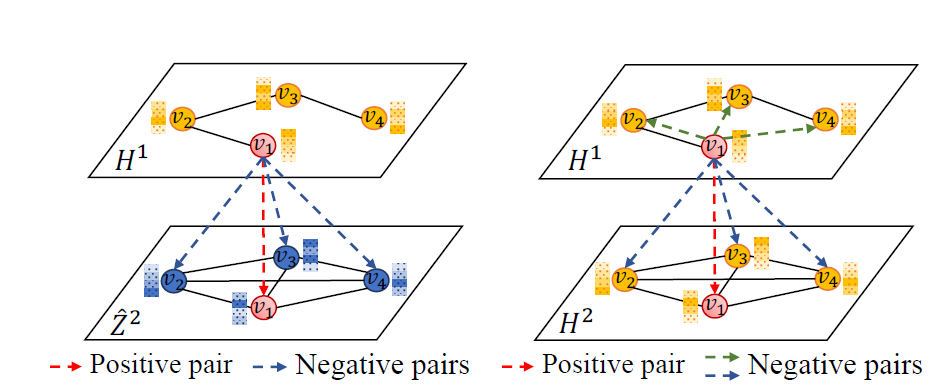
解决:本文提出了一种新的自监督方法,通过多尺度对比学习增强孪生网络自蒸馏来学习节点表示。具体来说,首先从输入图生成两个增强视图,这两个增强视图分别是基于局部和全局视图的。然后采用两个目标,即跨视图(cross-view)和跨网络(cross-network)的对比性,最大化不同视图和网络的节点表示之间的一致性。
多尺度:cross-view中视图内和视图间两种尺度的对比学习,不同视图下cross-network的对比学习。
孪生网络:狭义的孪生神经网络(siamese network)由两个结构相同,且权重共享的神经网络拼接而成。广义的孪生神经网络,或伪孪生神经网络(pseudo-siamese network),可由任意两个神经网拼接而成,不共享权值。孪生神经网络用于处理两个输入”比较类似”的情况。伪孪生神经网络适用于处理两个输入”有一定差别”的情况。siamese network的初衷是计算两个输入的相似度,。传统的siamese network使用Contrastive Loss。
自蒸馏(Self Distillation)是三种知识蒸馏学习方法的一种:离线蒸馏(Offline Distillation)、在线蒸馏(Online Distillation)、自蒸馏(Self Distillation)。这三种蒸馏方法区别是:
离线蒸馏(Offline Distillation): teacher模型是已经预训练好的,已经有很好的效果。再让teacher模型来指导student模型进行学习,完成知识蒸馏。
在线蒸馏(Online Distillation):teacher模型没有预训练,准备和student模型一同进行训练,在一同训练的过程中来指导student模型进行学习,完成知识蒸馏。
自蒸馏(Self Distillation):teacher模型和student模型是一个模型,也就是一个模型来指导自己进行学习,完成知识蒸馏。
二、Introduction
图表示学习:学习节点或图的低维嵌入,以保存底层的结构和属性信息。
在本文中,为了缓解现有GCL(图对比学习)方法的缺点,并利用孪生网络中的bootstrapping,我们提出了一个简单但强大的框架来学习节点级表示,我们称之为多尺度对比孪生网络。
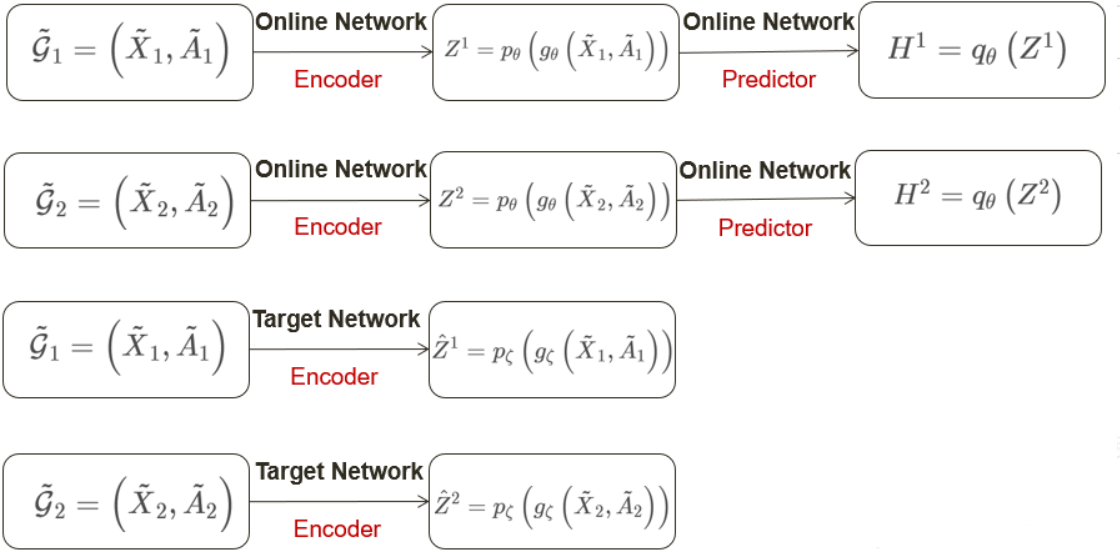
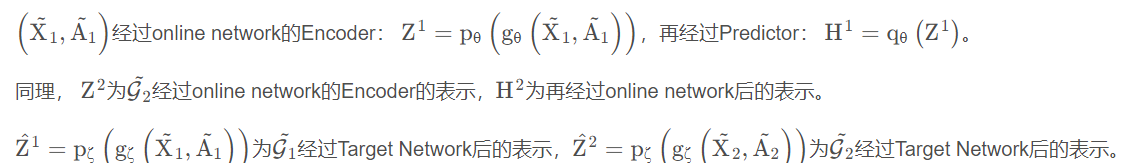
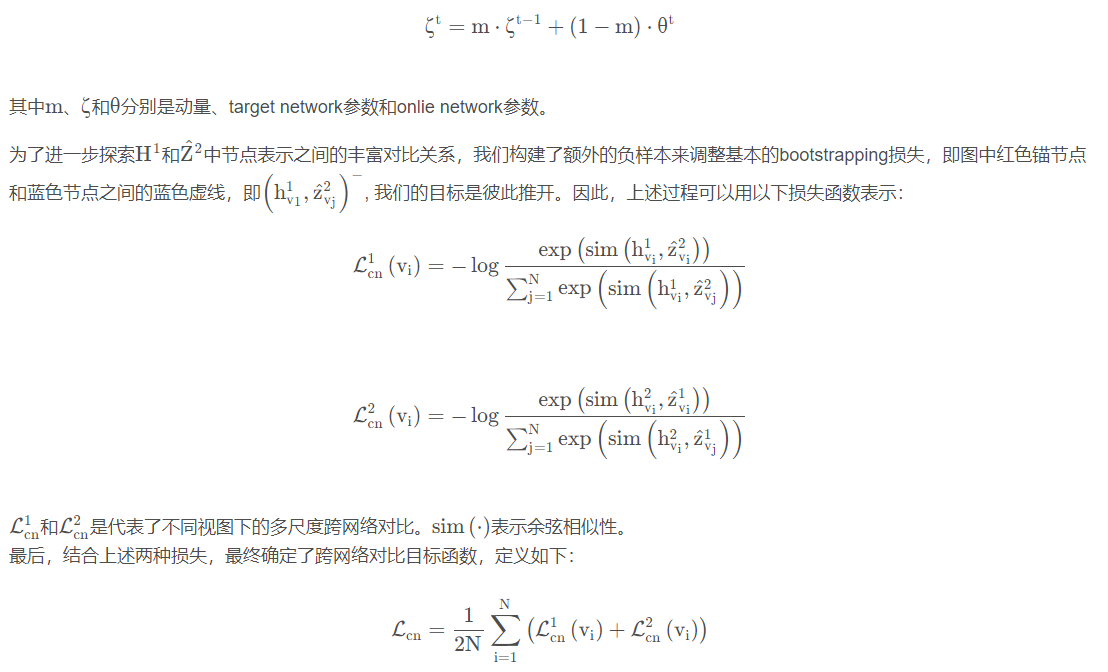
我们的方法旨在优化两个目标,即跨网络和跨视图的对比。首先,考虑到现有的GCL方法严重依赖于负样本来避免表示崩溃,我们建议使用动量驱动的孪生体系结构作为我们的主干,分别从online network和target network的不同视图最大化节点表示之间的相似性。
背后的直觉是,在我们的框架中缓慢移动的target network充当了一个稳定的“平均教师”来编码历史观察,这引导online network学习探索更丰富和更好的表示,而不依赖额外的负样本来避免表示崩溃。然而,仅仅优化这个目标会忽略丰富的底层图拓扑信息。为了部分地缓解这个问题,我们注入额外的负样本,在两个网络的不同视图中推开不同的节点。
其次,我们建议进一步利用节点连通性,并在online network中引入视图内和视图间的多尺度对比学习,以规范我们方法中上述bootstrapping目标的训练。
bootstrapping:用原样本自身的数据抽样得出新的样本及统计量。在现实问题中,对总体进行多次抽样常常是不方便的甚至是无法实施的,所以就只进行一次抽样得到一个样本,再在这个样本中进行多次有放回地抽样,得到多个“样本的样本”,这样通过统计这些小样本的分布,就能得到总体的估计量(例如方差、标准差等)。
平均教师
三、framework
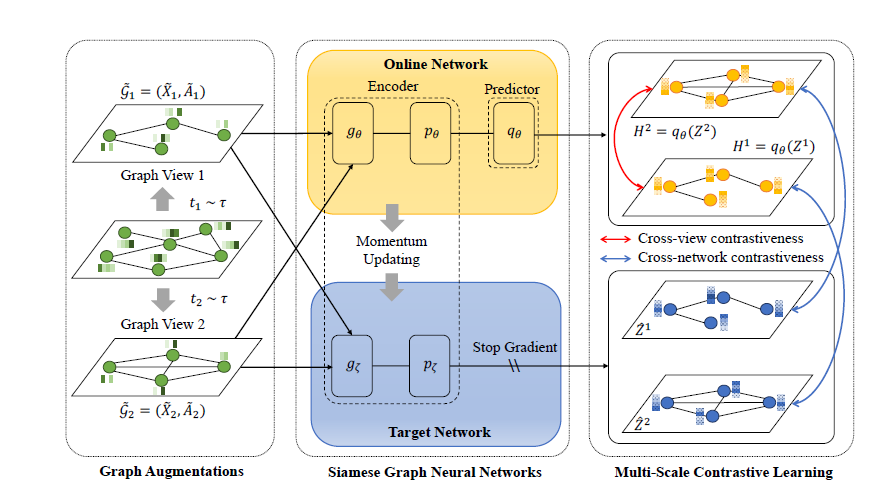
模型主要由三部分组成:图增强、跨网络对比学习和跨视图对比学习。
(一)Graph Augment
1.Graph Diffusion(GD)
图扩散: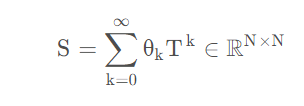
θ \thetaθ是控制局部和全局信号分布的参数;
T ∈ R N × N
是传递邻接矩阵的转移矩阵。
本文采用Personalized PageRank(PPR)kernel来支持图扩散,上式重新表述为: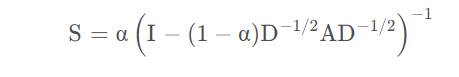
A 为邻接矩阵,I为单位矩阵,D为度矩阵,α为随机游走传送概率的可调参数。
2.Edge Modification(EM)
在邻接矩阵中删除边,并添加了相同数量的边。通过这种方式,可以保持原始图的属性,同时使用额外的边使增强视图复杂化。具体来说,给定邻接矩阵A 和修改率P,我们在原始图中随机删除现有边的P / 2部分,然后在图中随机添加相同部分的新边。我们的边缘下降和添加过程都遵循独立的均匀分布。
3.Subsampling(SS)
在邻接矩阵中随机选择一个节点索引作为拆分点,然后使用它裁剪原始图,创建一个固定大小的子图作为扩充图视图。
4.Node Feature Masking(NFM)
给定特征矩阵X和增强比P,我们随机选择X中节点特征维度的P部分,然后用零屏蔽它们。
SS+EM+NFM应用于第一个视图,并将SS+GD+NFM应用于第二个视图。这样,我们的模型可以通过对比学习对局部和全局信息进行编码。
(二)Cross-Network Contrastive Learning