Contrastive Multi-View Representation Learning on Graphs
Contrastive Multi-View Representation Learning on Graphs
【背景和动机】
1)基于GNNs的方法仍然需要专门的编码器来学习图或节点级表示。
2)如何将多视图增强方法应用于图数据。
为了解决上述两个问题,引入了一种自监督的方法来训练图编码器,通过最大化从不同的图的结构视图编码的表示之间的MI。我们表明,我们的方法在不需要专门架构的情况下,在节点和图分类任务上都优于以前的具有显著边际的自监督模型。
为了进一步改进节点和图分类任务上的对比表示学习,论文系统地研究了我们的框架的主要组成部分,并令人惊讶地表明,与视觉对比学习不同:
(1) 增加视图的数量,即增加,到超过两个视图并不能提高性能,最佳性能是通过对比一阶邻居的编码和一般的图扩散。
(2) 与对比图形图或多尺度编码相比,跨视图对比节点和图编码在两个任务上都获得了更好的结果。
(3) 与可微池(DiffPool)等分层图池方法相比,一个简单的图读出层在这两个任务上都取得了更好的性能。
(4) 应用正则化(提前停止除外)或归一化层对性能有负面影响。
通过利用这些发现,论文得以提出模型。
【方法】

本文的模型主要分为四个模块,下面依次介绍这几个模块的作用:
【数据增强】
图的数据增强方法可以分为两种方法,第一种是对于特征的增强方法,例如随机添加高斯噪声,随机mask掉一些特征维度等等。
第二种增强方法是结构上的增强,包括添加或者减少一条边,或者使用最短路径等其他方法来得到新的视图。
作者提出第一种基于特征空间的增强并不能提升性能,反而会是性能下降,所以作者本文选择使用结构上的增强方法,作者提出两个矩阵来生成第二个视图(第一个视图即为无任何操作的视图):
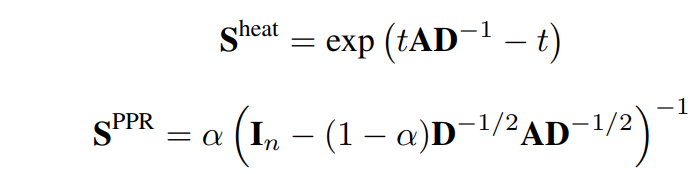
这俩个矩阵分别是通过heat kernel和Personalized PageRank来近似计算得到的
并以这两个矩阵来作为第二个视图的邻接矩阵,在本文中,作者通过实验发现 作为第二个视图可以达到最佳的效果,作者认为邻接矩阵A可以视为图的局部信息,而
 则提供了全局的信息,这样两个视图就可以获得更加充分的信息。
【编码器】
本文主要通过编码器获得两个层次的embedding:
一个是使用最基础的GCN编码器,并且在之后加入了一个两层的MLP层来获得两个视图的节点表示 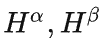 。
然后作者提出了一个readout function来获得图表示:
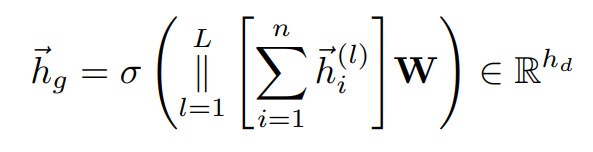
首先把从GCN里出来的节点表示做一个列求和,即把矩阵从N x D维度变成了1 x D维度,然后再将每一层的结果堆积起来,即假设GCN有3层,那么最后图表示的维度就是3 x D维,最后这个图表示需要再过一遍MLP,这个MLP的参数维度是(L x D)x D,最后相乘的结果就是1 x D,这就是最后图层次的表示, ,维度为1 x D维度。
注意最后由于每个层次都有两个视图的信息,所以最后需要把两个视图的信息相加然后再去进行下游任务。
【对比训练】
本文使用最大化互信息的目标函数来进行对比学习:
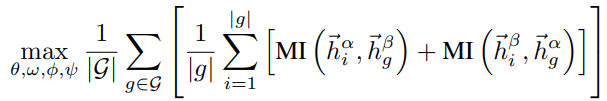
其中 分别表示节点i在两个视图下的表示,都是1 x D维,而 和
 则分别表示两个视图下的图表示,也都是1 x D维。
所以这是两个不同视图,而且不同层次的对比学习,可能这样可以学习到的信息比较多。
本文使用的MI互信息计算一共使用了四种,分别是NCE 估计,JS散度,NT-Xent交叉熵,还有KL散度的DV表示,都是用来计算两个概率分布之间的相似度的。
【实验结果】
本文进行了node-level的task和graph-level的task,其中节点分类结果如下:
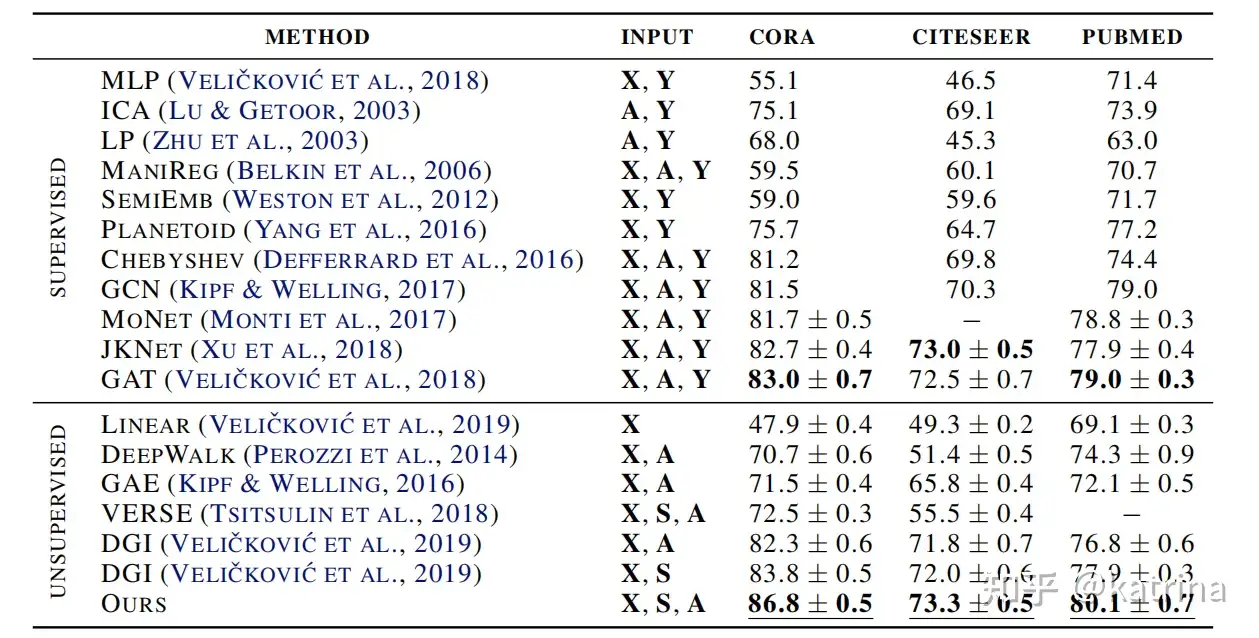
注意到这里的无监督并不是指没有用标签,而是在本模型训练过程中没有用到标签,但是最后需要使用一个线性层来对最终的结果做调整,其实是用到了标签了的。
节点聚类的结果:
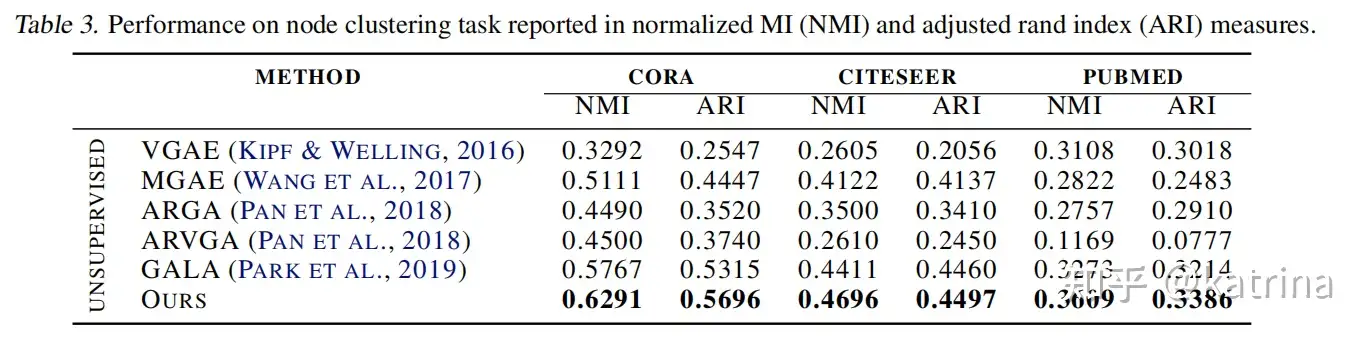
可以看到这里Cora上的NMI达到了62.91,这个是一个很高的数值的,我感觉比现在很多做节点聚类的结果还要好很多。
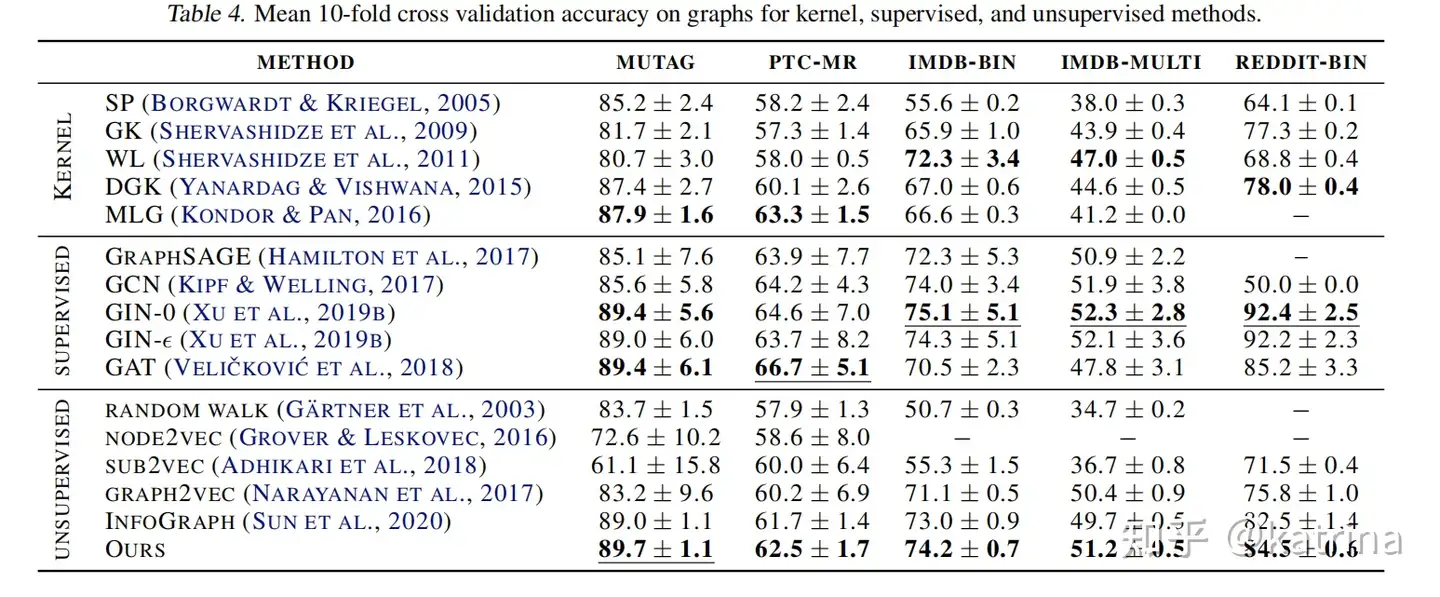
在图分类上的准确率:
此外作者进行了大量的消融实验:
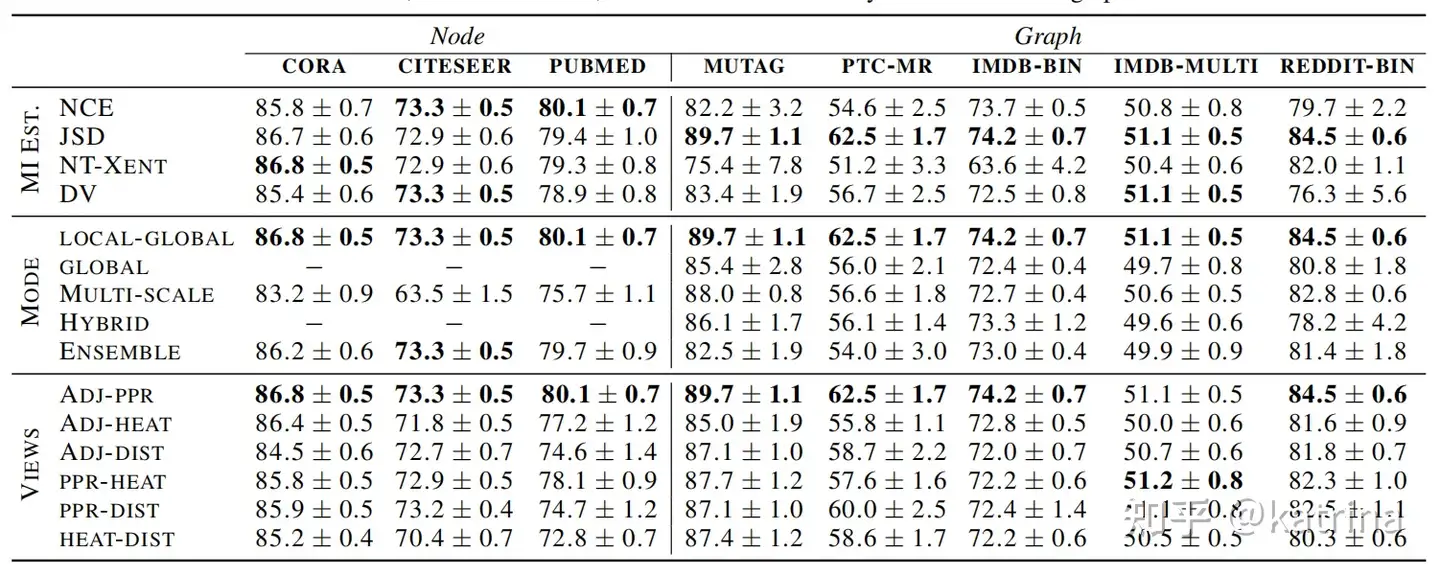
作者对比了四种MI估计的效果,发现JSD在图分类上取得了最大的效果。
作者对比了不同模式的对比学习,这里主要有local-global的对比是指节点表示和图表示之间的对比,global则是指不同视图的图表示之间的对比,multi-scale则是指利用了diffpool的方法来进行分层次的对比,hybrid则是指同时使用了local-global和global的对比,ensemble则是指在同一个视图对节点表示和图表示进行对比学习。
作者还对比了不同视图下的效果,ADJ则是指图邻接矩阵,PPR是指图的Personalized-PageRank近似矩阵,HEAT是指heat kernel计算出来的近似矩阵,DIST则是指利用了FloydWarshar算法得到的最短路径,后面这三个都是表示着图的全局信息,ADJ则表示这图的局部信息,结果表示ADJ-PPR的效果是最好的,而PPR-HEAT则在一个图分类数据集上取得了最佳效果,所以作者在前文提到了HEAT矩阵。