GPT-2
GPT-2:多任务学习
GPT-2继续沿用了原来在GPT中使用的单向 Transformer 模型,而这篇文章的目的就是尽可能利用单向Transformer的优势,做一些BERT使用的双向Transformer所做不到的事。那就是通过上文生成下文文本。
GPT-2的改进
1. 去掉了fine-tuning层:不再针对不同任务分别进行微调建模,而是不定义这个模型应该做什么任务,模型会自动识别出来需要做什么任务,是很通用的设计。
2. 增加数据集:GPT-2手机了更加广泛,数量更多的语料组成数据集。该数据集包含800万个网页,大小为40G。这些数据是经过过滤后得到的高质量文本。
3. 增加网络参数:GPT-2将Transformer堆叠的层数增加到48层,隐层的维度为1600,参数量达到了15亿。(5倍于BERT的参数量)
4. 调整Transformer:将layer normalization放到每个sub-block之前,并在最后一个self-attention后再增加一个layer normalization
此外,GPT-2将词汇表数量增加到50257个;最大的上下文大小从GPT-1的512提升到了1024 tokens;batch-size增加到512.
模型参数
- 同样使用了使用字节对编码构建字典,字典的大小:50257
- 滑动窗口大小:1024
- batch-size:512
- Layer Normalization移动到了每一块的输入部分,在每个self-attention之后额外添加了一个Layer Normalization
- 将残差层的初始化值用
 进行缩放,其中N是残差层的个数
GPT-2训练了4组不同的层数和词向量的长度的模型,见表:
| 参数量 | 层数 | 词向量长度 |
|---|---|---|
| 117M(GPT-1) | 12 | 768 |
| 345M | 124 | 1024 |
| 762M | 36 | 1280 |
| 1542M | 48 | 1600 |
效果如下:
可以看出随着模型的增大,模型的效果是不断提升的。模型仍欠拟合,后续还会加大数据量,做大做强。
GPT-2能够适应多任务
在训练的时候,采用了多任务的方式,不单单只在一个任务上进行学习,而是多个,每一个任务都要保证其损失函数能收敛,不同任务是共享主题Transformer参数的,进一步提升模型的泛化能力,因此在即使没有fine-tuning的情况下,依旧有非常不错的表现。
在fine-tuning有监督任务阶段,GPT-2根据给定输入与任务来做出相应的输出,那么模型就可以表示成下面这个样子:
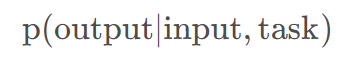
例如可以直接输入:(“自然语言处理”, 中文翻译)来得到我们需要的结果(“Nature Language Processing”),因此提出的模型可以将机器翻译,自然语言推理,语义分析,关系提取等10类任务统一建模为一个分类任务,而不误再为每一个子任务单独设计一个模型。