GPT-1
Improving Language Understandingby Generative Pre-Training
一 背景
GPT1:Generative Pre-Training。是一种生成式的预训练模型,由OpenAi团队发表自论文《Improving Language Understanding by Generative Pre-Training》。该模型的核心思想:通过二段式的训练,第一个阶段是利用语言模型进行预训练(无监督形式),第二阶段通过 Fine-tuning 的模式解决下游任务(监督模式下)。GPT-1可以很好地完成若干下游任务,包括分类、蕴含、相似度、多选等。在多个下游任务中,微调后的GPT-1系列模型的性能均超过了当时针对特定任务训练的SOTA模型。
二 模型整体结构(宏观)
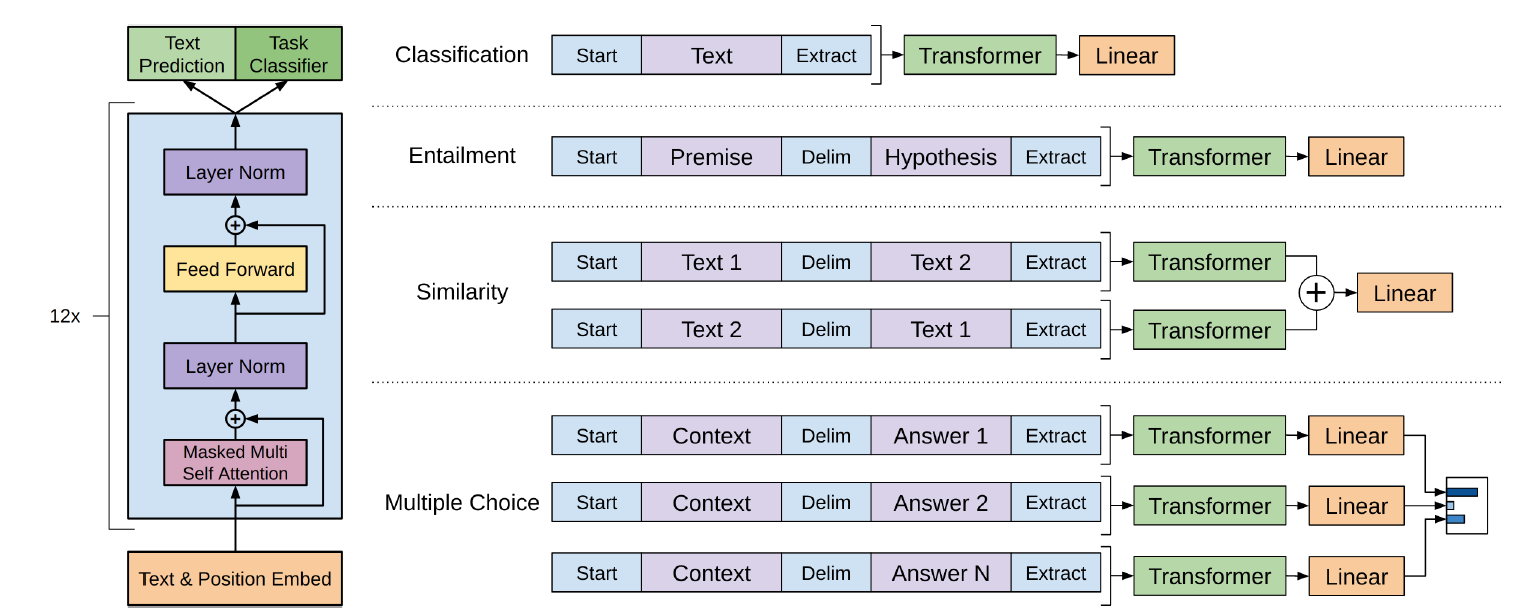
左侧为模型的整体结构,由12个Transformer中的Decoder模块经修改后组成。
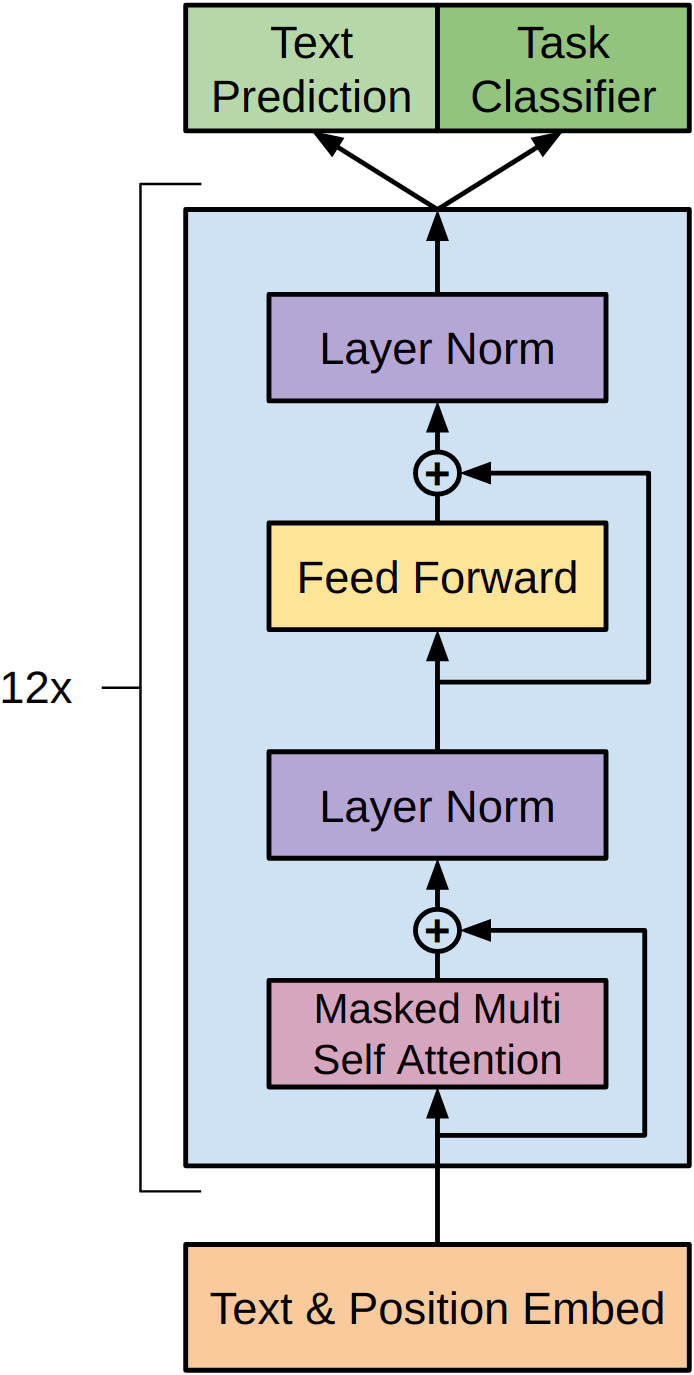
其中,k是上下文窗口的大小。在模型结构上,GPT-1选择了Transformer Decoder作为其主要组成部分。GPT-1由12层Transformer Decoder的变体组成,称其为变体,是因为与原始的Transformer Decoder相比,GPT-1所用的结构删除了Encoder-Decoder Attention层,只保留了Masked Multi-Head Attention 层和Feed Forward层。Transformer结构提出之始便用于机器翻译任务,机器翻译是一个序列到序列的任务,因此Transformer设计了Encoder用于提取源端语言的语义特征,而用Decoder提取目标端语言的语义特征,并生成相对应的译文。GPT-1目标是服务于单序列文本的生成式任务,所以舍弃了关于Encoder部分,包括Decoder的 Encoder-Dcoder Atcnion层。
GBT保留了Decoder的Masked Multi-Atenlion 层和 Fed Forward层,并扩大了网络的规模。将层数扩展到12层,GPT-1还将Atention 的维数扩大到768(原来为512),将Attention的头数增加到12层(原来为8层),将Fed Forward层的隐层维数增加到3072(原来为2048),总参数达到1.5亿。GPT-1还优化了学习率预热算法,使用更大的BPE码表,活函数ReLU改为对梯度更新更友好的高斯误差线性单元GeLU,将正余弦构造的位置编码改为了带学习的位置编码。
3.无监督的预训练过程:
GPT-1在无然督训练阶段,依然采用标准的语言模型,即给定无标签的词汇集合u = { u 1 , . . . , u 2 },最大化以下似然函数:
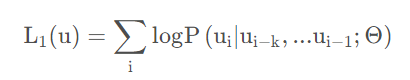
其中,k为上下文窗口大小, Θ 为模型参数,其训练方式使用的是Adam优化器。
首先根据token embedding matrix We 和position embedding matrix Wp 来计算得到模型的输入:
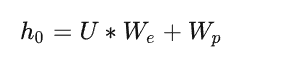
其次将输入传进Decoder模块:
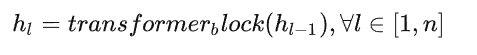
n为Decoder的层数。
最后,经过n次上述步骤以后,将最终输出的结果 hn 传入softmax进行计算,得到对应的标签的概率分布。
4.有监督的微调过程:
假设监督数据集合C的输入X是一个序列x1,x2,…,xm,输出是一个分类y的标签。
把 x1,..,xm 输入 Transformer 模型,得到最上层最后一个时刻的输出 hlm ,将其通过我们新增的一个 Softmax 层(参数为 Wy )进行分类,最后用交叉熵计算损失,从而根据标准数据调整 Transformer 的参数以及 Softmax 的参数 Wy 。这等价于最大似然估计:
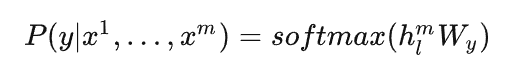
Wy 表示预测输出时的参数,微调时候需要最大化以下函数:
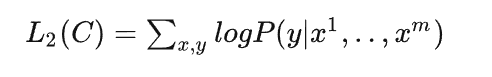
正常来说,我们应该调整参数使得 L2 最大,但是为了提高训练速度和模型的泛化能力,我们使用 Multi-Task Learning(多任务学习),GPT 在微调的时候也考虑预训练的损失函数,同时让它最大似然 L1 和 L2
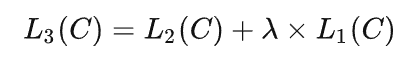
这里使用的 L1 还是之前语言模型的损失(似然),但是使用的数据不是前面无监督的数据 U ,而是使用当前任务的数据 C ,而且只使用其中的 X ,而不需要标签y。
针对其它任务,有相应的的微调方式,可以参考图一右侧。