skip-gram
目前最常用的词向量学习方法有三个:
Skip-Gram和CBOW(Continuous Bag-of-Words:连续词袋模型)出自2013年Tomas mikolov等人攥写的论文“Efficient Estimation of Word Representations in Vector Space”3中。因此,skip-gram和CBOW是一对孪生兄弟,其原理和实现过程高度相似,所以只要我们掌握清楚一个,另外一个也就迎刃而解。本节,我们将学习skip-gram和CBOW模型训练获得词向量的方法,并弄清它们的差异。
\1. skip-gram和CBOW的基本理念
skip-gram和CBOW的基本理念是构造一个假的学习任务,我们并不关注这个任务的输出结果如何,而是关注它的中间产物。举个例子,我们和小伙伴约定去打羽毛球,我们并不是很在意和小伙伴打球谁输谁赢,只要我们都靠运动锻炼了身体就好。这个例子中比赛的输赢就是假的学习目标,而通过这个过程锻炼好的身体就是我们的实际目标——词向量
我们已经明确skip-gram和CBOW的实际学习目标是要获得词向量,那么我们该如何构造假的学习任务(Fake Task)起到完成实际学习目标的效果呢?我们先以skip-gram为例, 构造Fake Task如下:
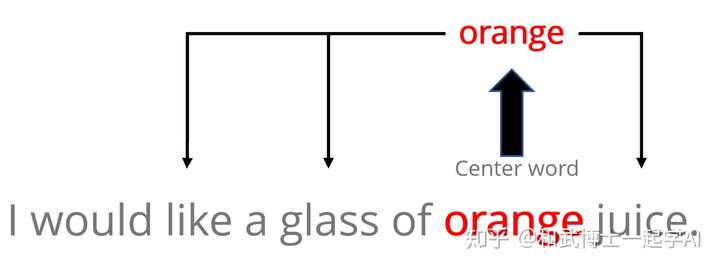
Skip-Gram Fake Task:以这个句子中的某个词作为训练输入(比如orange,通常把这样的词叫做中心词(center word)),以这个词周围的词(比如juice,也叫做上下文词(context word))作为训练标签,通过输入和标签训练模型,训练一个输入中心词预测上下文词的模型。
而CBOW模型则与之相反,它的Fake Task是通过输入上下文词来预测中心词,其原理是一样的。
大题知晓了skip-gram的Fake Task是如何构造之后,我们还需要理解为什么这种假学习目标的构造方式可以让我们实现真实目标(即为什么和小伙伴比赛羽毛球可以锻炼我们的身体)。
2 为什么这个Fake Task可以得到词向量?
首先我们要对这个假学习目标加上二个合理假设以辅助理解。
- orange和apple都是水果,所以是一个相似度很高的词语。
- orange和apple都经常和juice一起出现,即我们的待训练语料库中有很多orange juice和apple juice。
所以我们拟得到的许多训练样本可能是这个样子的。
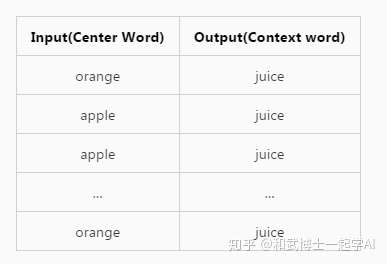
Input(Center Word)Output(Context word)orangejuiceapplejuiceapplejuice…………orangejuice当我们输入一个Input到模型中去时,模型会根据它的参数将我们的输入Input映射成输出Output。(若是以神经网络模型为例,这样的模型参数通常是通过梯度下降学习得来的)所以我们是否可以认为,由于我们输入了大量的Input是orange和apple,而它们的Output都是juice(实际还有其它,比如可能有fruit),即我们输入了不同的东西,却得到了相同的东西,所以在模型习得的参数空间中,针对orange和apple的参数变成了高度相似的 。而这个词的对应模型参数,就是这个词的向量表示,这些参数的集合,就是我们的词向量。
\3. 实现细节
接下来我们将以一个句子来剖析一下skip-gram的实现细节:
首先我们定义以下句子:
I would like a glass of orange juice.
接着我们选定第一个词作为中心词(center word):
[ I ] would like a glass of orange juice.
为了找到它的上下文词,我们引入一个window_size参数,并将其设定为2,这代表这个中心词左右2个单词将作为它的上下文词(context word)。这时我们就获得了2个训练样本,输入为单词”I”, 输出标签为”would”和”like”。
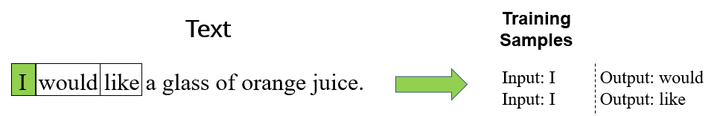
接下来我们只要滑动这个中心词窗口,就可以获得越来越多且不同的训练样本。
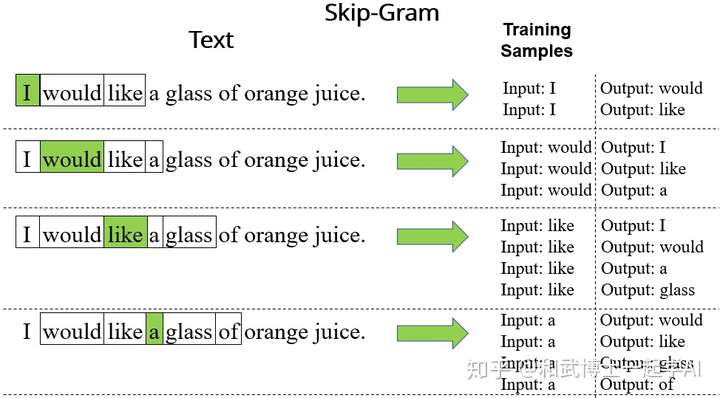
这样我们的神经网络模型在遍历整个语料库的时候(比如维基百科文本)将看到寻多个(center: orange, context: juice)样本(相对于(orange, Ak47)样本来说),同理也会看到许多个(apple, juice)样本。
对应第2小点的内容,这样使得模型不管看到”orange”还是看到”apple”都要预测出”juice”,就”逼”着它让它学习让它认为这两个单词是高度相似的,即我们最终得到的”orange”和”apple”词向量是高度相似的。
而CBOW则与之相反,用的是上下文词来预测中心词。但是与skip-gram有一点差别的是,它获得的训练样本并非是直观以为的(context: juice, center: orange)。而是将窗口内的所有上下文词放在一起来预测中心词,即(context: [glass, of, juice], center: orange),即:
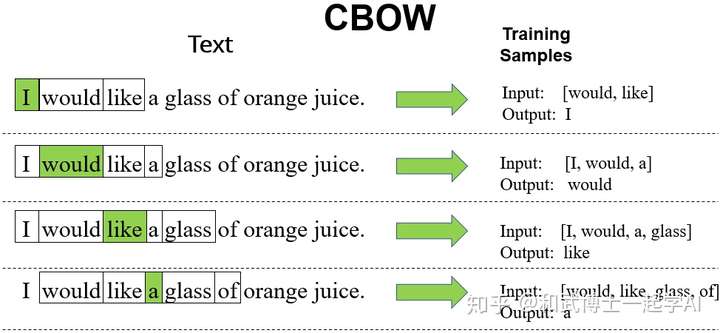
这细微的差别带来的却是模型效果的大相径庭,我们将在下面看到。
\4. Skip-Gram模型和CBOW模型有和异同?
我们先说相同点,Skip-Gram和CBOW模型都是构造Fake Task,利用句子中的词去预测其它词从而获得单词的词向量。
而它们的不同点来源于上文提到的小差别。CBOW的一个训练样本是(context: [glass, of, juice], center: orange),它对周围词的调整是统一的,CBOW的训练次数跟整个文本的词数几乎相等(每次训练滑动一次中心词窗格获得一个训练样本,而Skip-Gram滑动一次中心词窗格获得多个训练样本)。
由此可看出,Skip-Gram的训练次数是要多于CBOW的,训练时间要比CBOW长。
Skip-Gram训练时间长但也有它的好处。在skip-gram中,每个词在作为中心词的时候,都要进行K次(window_size * 2)的训练和调整。因此当训练语料库较小,或语料中多生僻词时, 这种多次调整会使得词向量更加精准(毕竟训练了多次)。
而在CBOW中,单词的词向量是和周围的词一起平均调整的(比如上述中”glass”、”of”、”juice”是一起调整的),代表若是存在生僻词,它并没有得到因材施教和专门的训练,而是和周围的词一起进行。
举一个通俗的例子。
Skip-Gram模型相当于是“家教学习模式”,即一个学生请了多个家教对其进行一对一辅导,表现为每个输入的中心词(学生)从多个上下文词标签(家教老师)那里获得知识。而CBOW模型则相当于“大班教学模式”,即多个学生在一个大班老师那里上课学习,表现为每个输入的多个上下文词(多个学生)从中心词标签(大班老师)那里获得知识。
因此家教学习模式耗时更久,但是学生得到了一对一照顾,学习效果更好。而大班教学耗时短,但是老师对学生一视同仁,学生的学习效果相对较差。
Skip-Gram与CBOW模型总结:
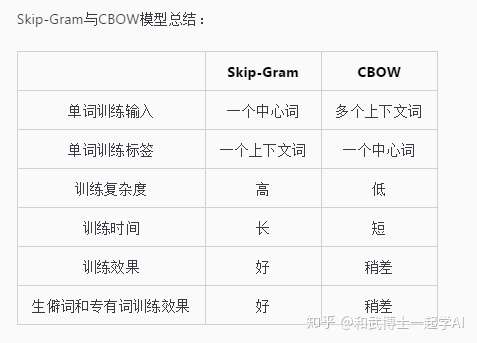
Skip-GramCBOW单词训练输入一个中心词多个上下文词单词训练标签一个上下文词一个中心词训练复杂度高低训练时间长短训练效果好稍差生僻词和专有词训练效果好稍差