simcse
EMNLP2021
说到计算两个句子的相似度,最直接的做法便是,将两个句子输入到BERT模型中,使用[CLS]对应的输出或者整个句子序列的输出的平均向量,作为句向量,然后再计算两个句向量的相似度。但是由于BERT模型的MLM与NSP这两个预训练任务的局限性,模型无法很好地学习到句子表征能力。
经过MLM与NSP任务训练之后,BERT无法学习到良好的句向量表示。
- MLM任务是遮住某个单词,让模型去预测遮住的单词,在这个训练中,模型并没有显式地对[CLS]向量进行训练,没有告诉模型[CLS]这个向量就是用来编码句子的语义信息的。在MLM任务中[CLS]学习到的并不是句子的语义表征。
- NSP任务是给定两个句子,让模型判断两个句子是否为上下文关系,使用[CLS]的输出来进行二分类。在这个任务中,[CLS]是用来编码两个句子之间的关系的,而不是描述某个句子的语义信息。
综上所述,未经过fintune的BERT模型,必然无法得到良好的句子的语义表征。
下图所展示的是在STS数据集中,文本相似度的分布情况,其中横坐标表示人类标注的句子相似度等级,纵坐标表示没有经过finetune的BERT模型预测的句子相似度分布。可以很明显看到模型预测的所有句子对的相似度,几乎都落到了0.6-1.0这个区间,即使含义完全相反的两个句子,模型输出的相似度也非常高。这便是BERT的句子表示的“坍塌”现象。
其中BERT的句向量的坍缩和句子中的高频词有关。当我们使用整个句子序列的输出的平均向量作为句向量时,句子中的高频词将会主导句向量,使得任意两个句向量之间的相似度都非常高。
Introduction
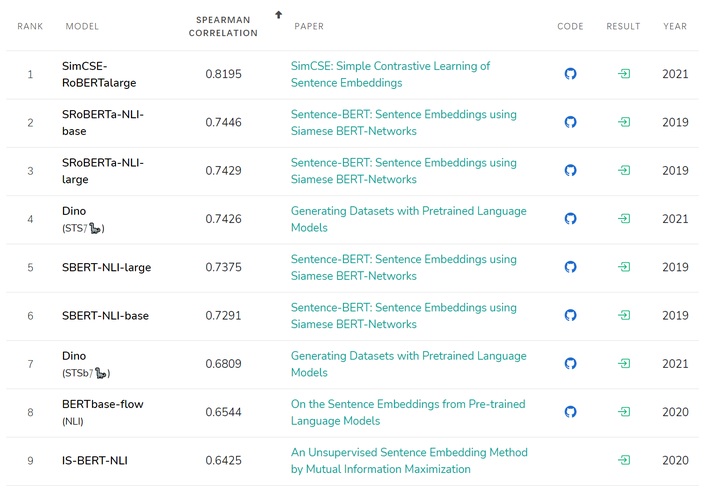
学习自然语言的通用语义表示一直是NLP的基础任务之一,然而当2019年的SBERT出现之后,语义相似度计算和语义匹配模型似乎就没有什么突破性进展了,2020年出现的BERT-flow和BERT-whitening主要是对无监督语义匹配的改进,而有监督语义匹配的SOTA一直是SBERT。SBERT本身并不复杂,仅仅是一个基于BERT的孪生网络而已,想要在SBERT的基础上改进指标,只能从训练目标下手,而本篇论文就将对比学习的思想引入了SBERT,大幅刷新了有监督和无监督语义匹配SOTA,更让人惊叹的是,无监督SimCSE的表现在STS基准任务上甚至超越了包括SBERT在内的所有有监督模型。
Background: Contrastive Learning
对比学习的思想说起来很简单,即拉近相似的样本,推开不相似的样本,一种常用的对比损失是基于批内负样本的交叉熵损失,假设我们有一个数据集,其中
和
是语义相关的,则在大小为
的mini batch内,
的训练目标为
其中,
和
是
和
的编码表示,
为softmax的温度超参。
Positive instances
使用对比损失最关键的问题是如何构造,对比学习最早起源于CV领域的原因之一就是图像的
非常容易构造,裁剪、翻转、扭曲和旋转都不影响人类对图像语义的理解,而结构高度离散的自然语言则很难构造语义一致的
,前人采用了一些数据增强方法来构造
,比如同义词替换,删除不重要的单词,语序重排等,但这些方法都是离散的操作,很难把控,容易引入负面噪声,模型也很难通过对比学习的方式从这样的样本中捕捉到语义信息,性能提升有限。
Alignment and uniformity
对比学习的目标是从数据中学习到一个优质的语义表示空间,如何评价这个表示空间的质量**Wang and Isola (2020)**提出了衡量对比学习质量的两个指标:alignment和uniformity,其中alignment计算和
的平均距离:
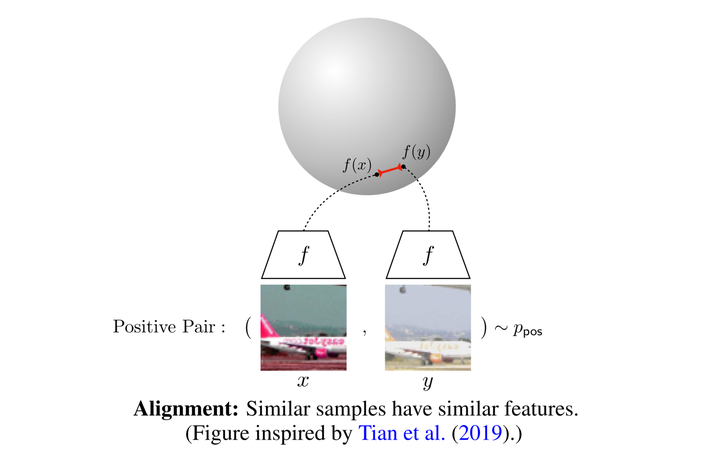
而uniformity计算向量整体分布的均匀程度:
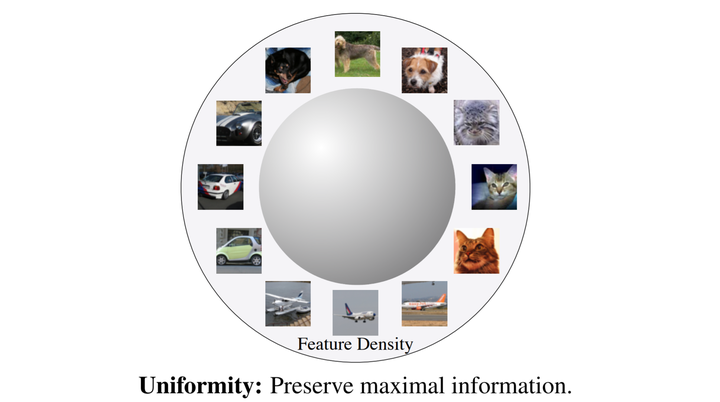
我们希望这两个指标都尽可能低,也就是一方面希望正样本要挨得足够近,另一方面语义向量要尽可能地均匀分布在超球面上,因为均匀分布信息熵最高,分布越均匀则保留的信息越多,“拉近正样本,推开负样本”实际上就是在优化这两个指标。在后文中,作者将会使用这两个指标来评价模型。
Unsupervised SimCSE
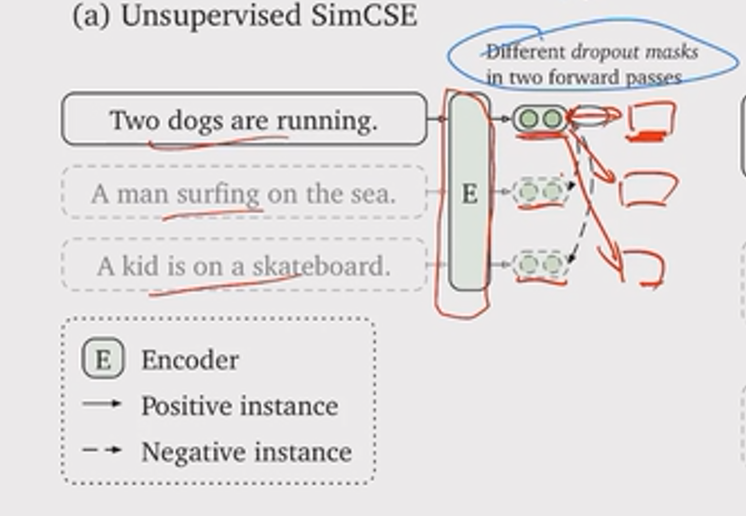
众所周知,直接用BERT句向量做无监督语义相似度计算效果会很差,任意两个句子的BERT句向量的相似度都相当高,正好,对比学习的目标之一就是学习到分布均匀的向量表示,因此我们可以借助对比学习间接达到规整表示空间的效果,这又回到了正样本构建的问题上来,而本文的创新点之一正是无监督条件下的正样本构建。
本文作者提出可以通过随机采样dropout mask来生成,回想一下,在标准的Transformer中,dropout mask被放置在全连接层和注意力求和操作上,设
,其中
是随机生成的dropout mask,由于dropout mask是随机生成的,所以在训练阶段,将同一个样本分两次输入到同一个编码器中,我们会得到两个不同的表示向量
,将
作为正样本,则模型的训练目标为
这种通过改变dropout mask生成正样本的方法可以看作是数据增强的最小形式,因为原样本和生成的正样本的语义是完全一致的(注意语义一致和语义相关的区别),只是生成的embedding不同而已。
Dropout noise as data augmentation
这种简单的正样本生成方式和其他显式的数据增强方式有明显的优势。作者从维基百科中随机抽取十万个句子来微调BERT模型,并在STS-B开发集上测试,实验结果如下表所示:
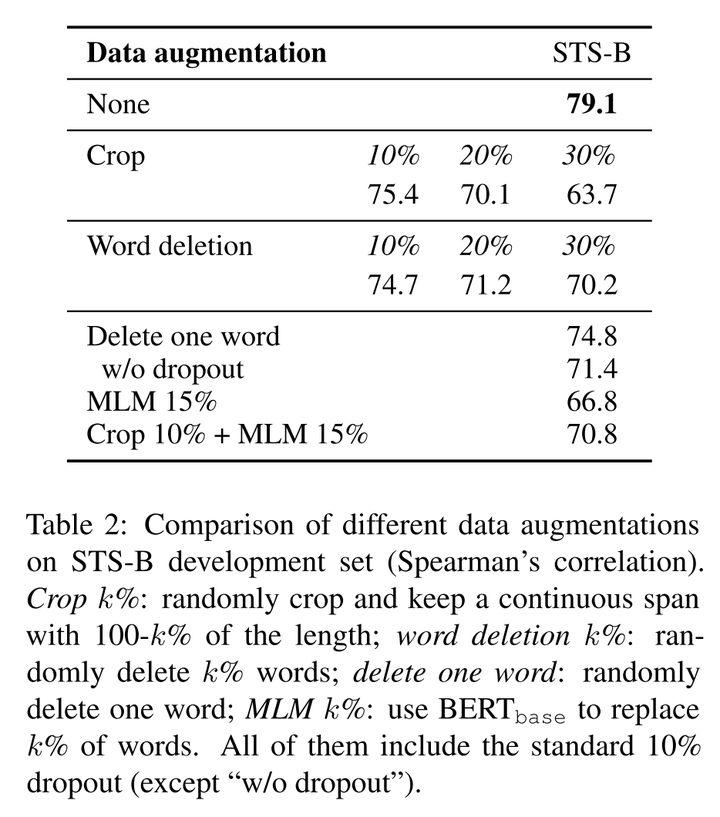
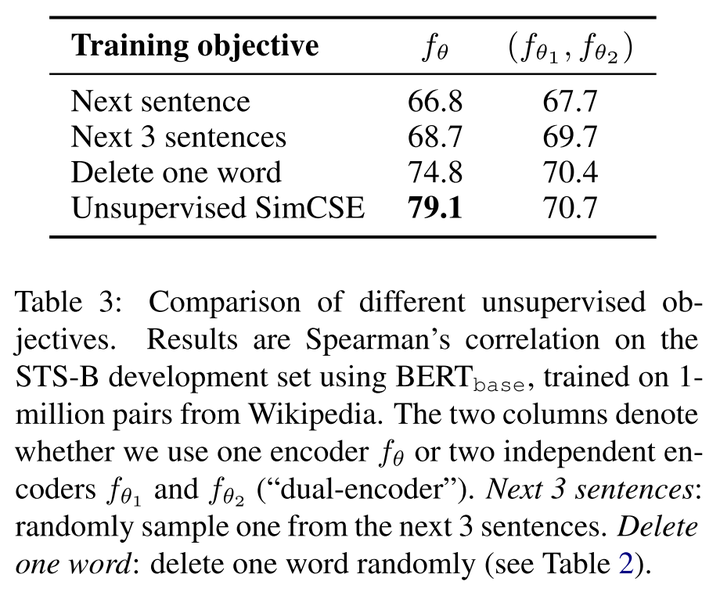
其中None是作者提出的随机dropout mask方法,其余方法均是在None的基础上改变的输入,可以看到,追加显式的数据增强方法都会大幅降低性能。作者也对比了这样的自监督方式和NSP目标的训练结果,如下表所示,将NSP作为正样本的构建方式明显很不科学,另外,做语义相似度计算一定要共享编码器。
Why does it work?
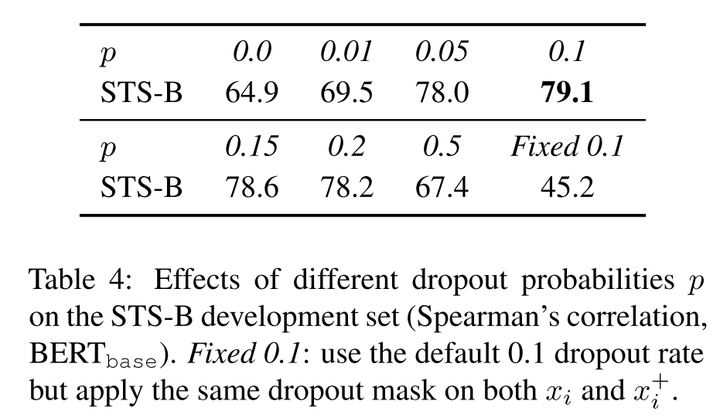
为什么这样的对比训练目标能work得这么好呢?作者首先尝试改变了dropout rate,发现默认的性能是最好的,去掉dropout或者固定dropout mask后模型性能都会出现大幅的下降,因为这时候
就和
一模一样,模型几乎什么都学不到。
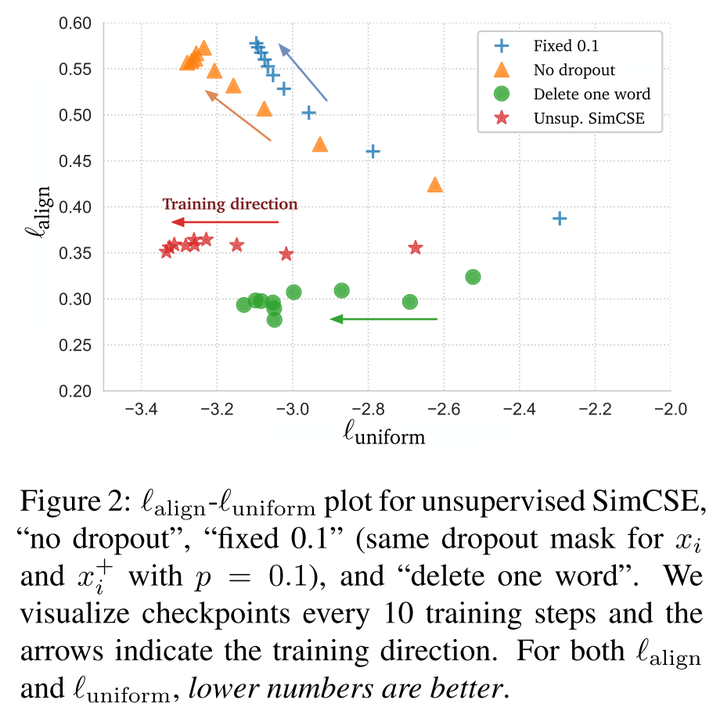
之前提到了衡量对比学习质量的指标:alignment和uniformity,作者用这两个指标测试了不同模型训练过程中保存的checkpoints,可视化结果如下图所示,可以发现所有模型的uniformity都有所改进,表明预训练BERT的语义向量分布的奇异性被逐步减弱,而与fix dropout和no dropout相比,SimCSE能在规整分布的同时保持正样本的对齐,与Delete one word相比,虽然alignment比不上delete one word,但由于其分布更加均匀,因此SimCSE总体性能更高。
Supervised SimCSE
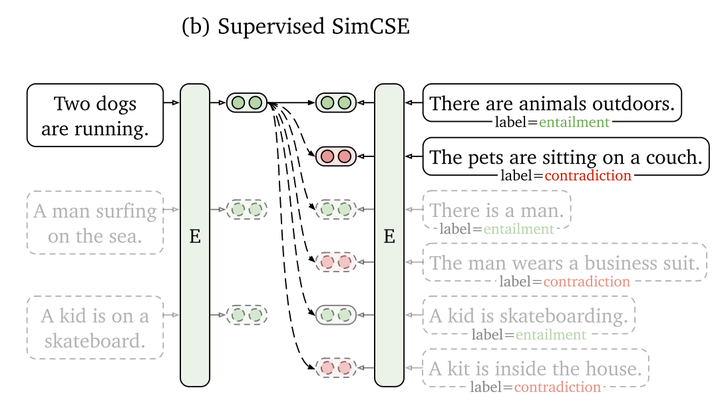
上面论述了SimCSE在无监督语义相似度任务上的优秀表现在SBERT原文中,作者将NLI数据集作为一个三分类任务来训练,这种方式忽略了正样本与负样本之间的交互(实际上SBERT文档中早已引入了对比损失,只是没有在原文中发表),而对比损失则可以让模型学习到更丰富的细粒度语义信息。
首先我们来考虑怎么构造训练目标,其实很简单,直接将数据集中的正负样本拿过来用就可以了,将NLI(SNLI+MNLI)数据集中的entailment作为正样本,conradiction作为负样本,加上原样本premise一起组合为,并将损失函数改进为
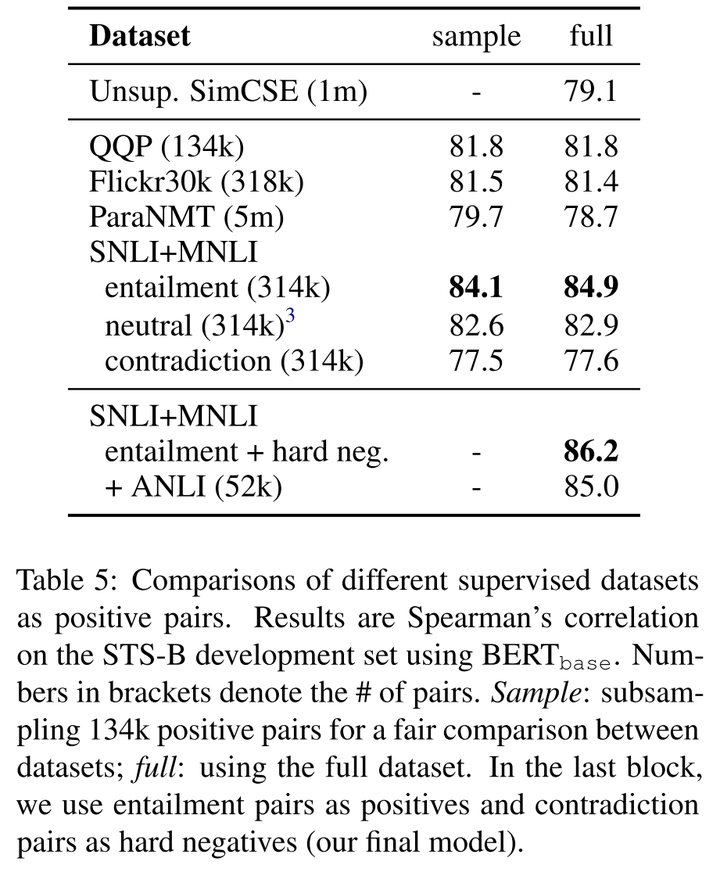
这里的可以被看作是hard negatives。另外,作者分别尝试在不同的语义匹配数据集上(QQP、Flickr、ParaNMT)训练模型,并在STS-B上测试模型,结果如下表所示,其中sample列表示采样相等样本量训练的结果,作者发现NLI训练出来的模型性能是最好的,这是因为NLI数据集的质量本身很高,正样本词汇重合度非常小(39%)且负样本足够困难,而QQP和ParaNMT数据集的正样本词汇重合度分别达到了60%和55%。
Experiment
Results
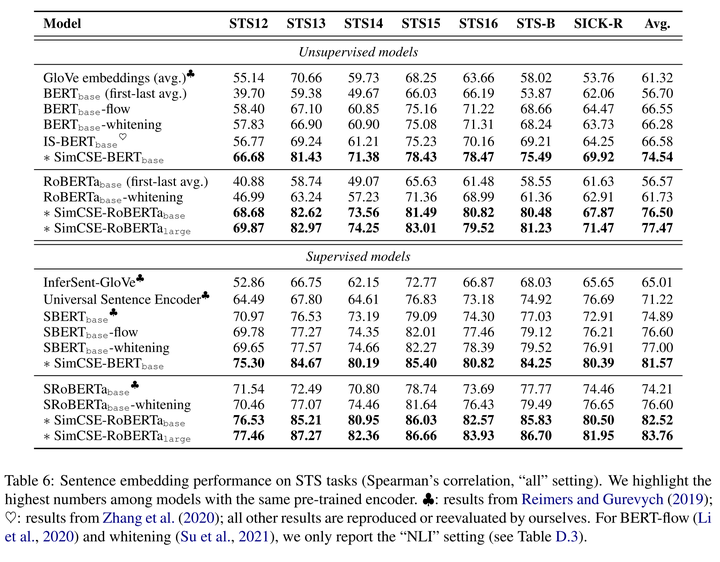
作者借助SentEval在多个数据集上评估了SimCSE的性能,如下表所示,可以发现,在STS系列任务上,SimCSE在无监督和有监督的条件下均大幅超越了之前的SOTA模型,而在迁移任务上,SimCSE也有着可观的性能提升,具体的实验细节可参考原文。
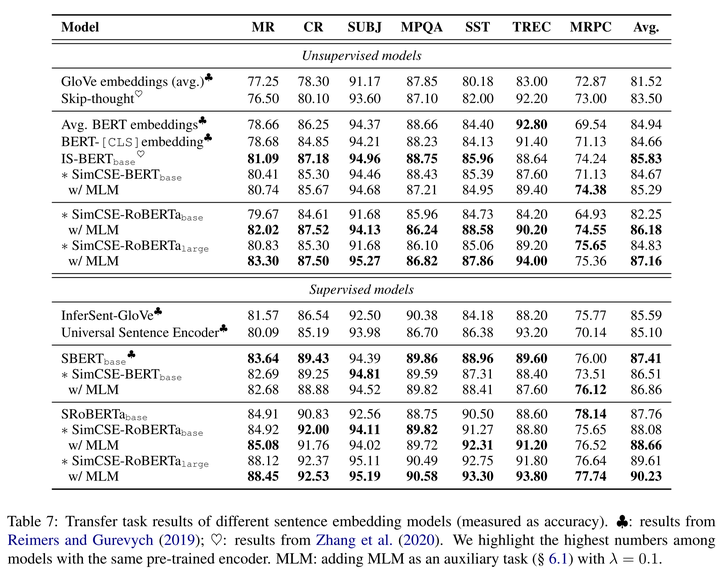
值得说明的是,在迁移任务上,作者尝试了加入MLM损失的trick:,直观上这缓解了模型对token级别信息的灾难性遗忘,实验结果表明这一额外损失能够提升模型迁移任务上的表现,但对STS任务没有明显帮助。
另外,作者没有比较BERT-flow和BERT-whitening,因为作者发现这些基于后处理的模型在迁移任务上表现还不如BERT,主要原因是这些任务的主要目标并不是学习可用于聚类的语义向量。
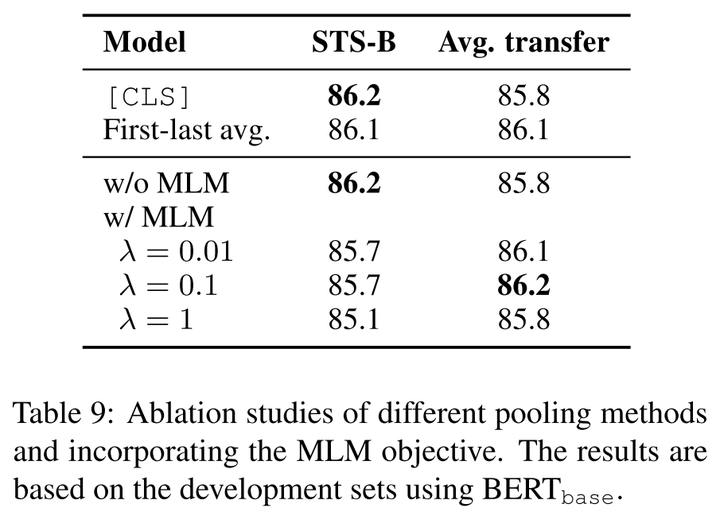
下面是一个关于池化层和MLM的ablation study,可以发现MLM损失对STS任务有负面作用,而对迁移任务有正面作用,但是作者并没有详细解释这其中的原因。
Analysis
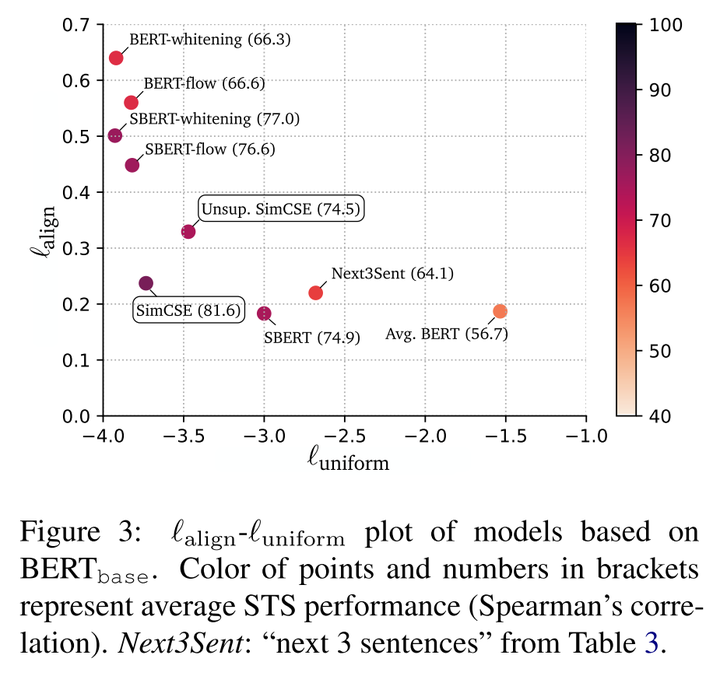
最后作者测试了现有模型的alignment和uniformity,如下图所示,可以发现性能更优的模型通常有着更好的alignment和uniformity,BERT虽然有很好的alignment,但uniformity太差,而基于后处理的BERT-flow和BERT-whitening又恰恰走向了另一个极端,本文提出的SimCSE则是对这两个指标的一个很好的平衡,加入监督训练后,SimCSE的两个指标会同时提升,这个结果和上面的理论证明完全吻合。
实验代码
实验所使用的训练集与原论文一致,均训练2个epoch,每隔100个step进行一次验证集的评测,并且保存最好的checkpoint。预训练权重使用bert-base-uncased,并且直接将BERT的[CLS]的输出作为句向量,没有添加额外的池化层。
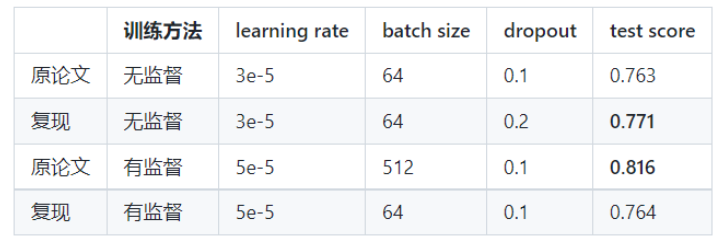
复现的总体效果如下表所示。可以看到,在无监督训练中,当dropout=0.2时,复现效果比原文略高。但在有监督训练中,复现效果与原论文的差距较大,甚至比无监督效果还略差。这个结果比较反常,笔者对代码进行了一轮debug,暂未定位到问题所在,后续会再次对有监督部分的训练代码进行排查。
无监督SimCSE
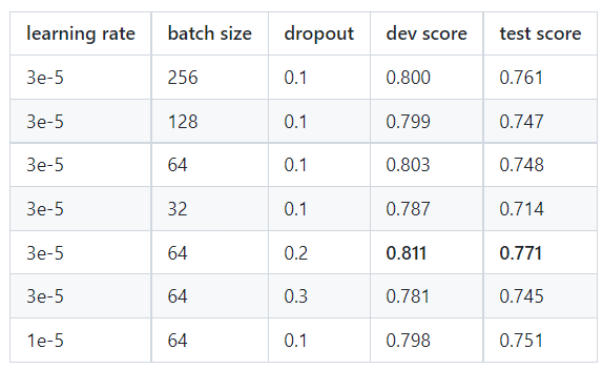
笔者在无监督任务上,对batch size、dropout进行了对比实验,实验结果如下表所示。我们发现模型在验证集与测试集的指标差距有点大,大概有3-5个点的差距,说明训练得到的模型的泛化能力还有待提高。