PGN
一、PGN 架构
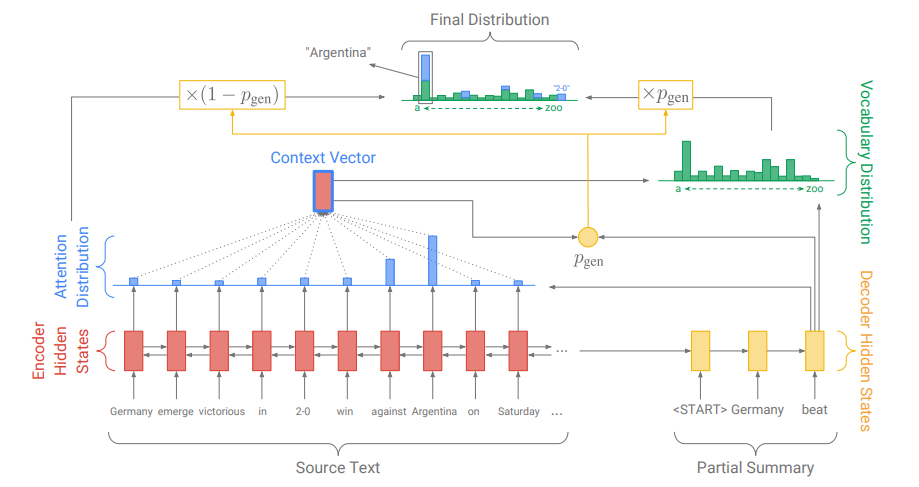
PGN( Pointer-Generator Networks, 指针生成网络),主要解决以上的第三点问题。PGN 可以将原文中的一些重要、低频单词直接 copy 到生成的文本摘要中,极大地避免 OOV 问题。
PGN 网络架构
以上是 PGN 的模型架构图,可以看出在 seq2seq + attention 的基础上,多了一层 pgen的计算。
- 先根据当前时间步的 decoder input 和 encoder 计算出的 context vector,计算出当前时间步的 pgen ;
- 然后用 1−pgen 乘以 Attention Distribution,得到原始文本的相关信息;
- 其次用 pgen 乘以 Vocabulary Distribution,得到生成文本的相关信息;
- 最后将这两部分信息相加,得到 Final Distribution。
详细来看,结合了PGN 的seq2seq 网络架构的计算流程可以分为以下的步骤。
- 计算 Attention Distribution(attention weight)
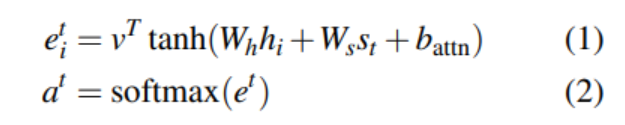
其中, hi 是由 encoder 计算得到的 encoder hidden state; st 是由 decoder 计算得到的当前时间步的hidden state。
\2. 计算 Context Vector
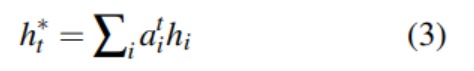
将 Attention Distribution 应用在 encoder hidden state 上,得到当前时间不的上下文 向量。
\3. 计算 Pvocab
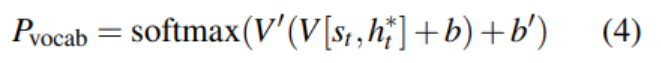
通过一个全连接层 + softmax,计算当前时间步的输出在词表上的生成概率。
\4. 计算 pgen
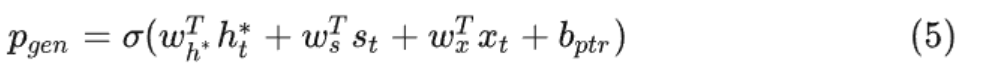

\5. 计算最终单词的概率分布
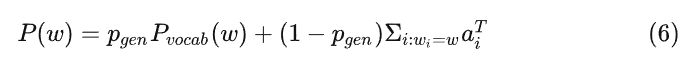
可以看出, pgen 类似于门控神经网络中的 gate,用于控制有多少的信息来自于原文,有多少的信息来自于根据神经网络生成的文本。如果一个单词没有在原文中出现过,那么上述公式(6)右侧的值等于0,也就是说这个单词生成的概率完全依赖于 seq2seq 网络;如果一个单词属于OOV,不在词表中,那么上述公式左侧的值等于0,也就是说这个单词生成的概率完全依赖于原文中的概率分布加和,相当于直接从原文中 copy 到生成的摘要文本中。
本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来自 Hello!